읽기 전에 먼저 풀어 보세요
먼저 한 문제
머신러닝이 사람이 규칙을 일일이 짜 넣는 방식과 가장 크게 다른 점은 무엇일까요?
알아야 할 배경
인공지능(AI)은 사람이 그때그때 끼어들지 않아도 정보를 이용해 판단하거나 예측하는 프로그램을 두루 가리키는 넓은 말입니다. 가장 단순한 AI는 사람이 '만약 이렇다면 저렇게 하라'는 규칙을 직접 짜 넣은 것입니다. 방 온도가 정해 둔 값보다 낮을 때 난방을 켜는 온도 조절기도 이런 규칙 기반 AI1에 속합니다.
머신러닝2(기계학습)은 AI의 한 갈래로, 이 규칙을 사람이 쓰지 않습니다. 대신 데이터를 보고 그 안의 패턴을 배운 뒤, 처음 보는 데이터에 대해서도 판단이나 예측을 내놓습니다. 그래서 머신러닝은 모두 AI에 들지만, AI가 모두 머신러닝인 것은 아닙니다.
스팸 메일 거르기를 예로 들어 보겠습니다. 규칙 방식이라면 사람이 어떤 메일이 스팸인지 기준을 손으로 정해야 합니다. 머신러닝에서는 알맞은 알고리즘(계산 절차)과 데이터만 고르면 됩니다. 모델이 예시 메일을 보고 스팸인지 맞혀 보면, 틀린 정도를 계산해 그만큼 줄이는 쪽으로 스스로를 조정하고, 정확해질 때까지 이를 되풀이합니다.
목표는 연습한 데이터가 아니라 실제로 쓰일 때 처음 만나는 데이터를 잘 맞히는 것이고, 이를 일반화3라고 합니다. 일이 복잡해질수록 따질 패턴과 변수를 사람이 전부 규칙으로 적기 어려워서, 데이터에서 배우는 이 방식이 AI의 주된 흐름이 됐습니다.
머신러닝은 배우는 방식에 따라 크게 세 가지로 나뉩니다.
요즘 왜 다시 중요할까
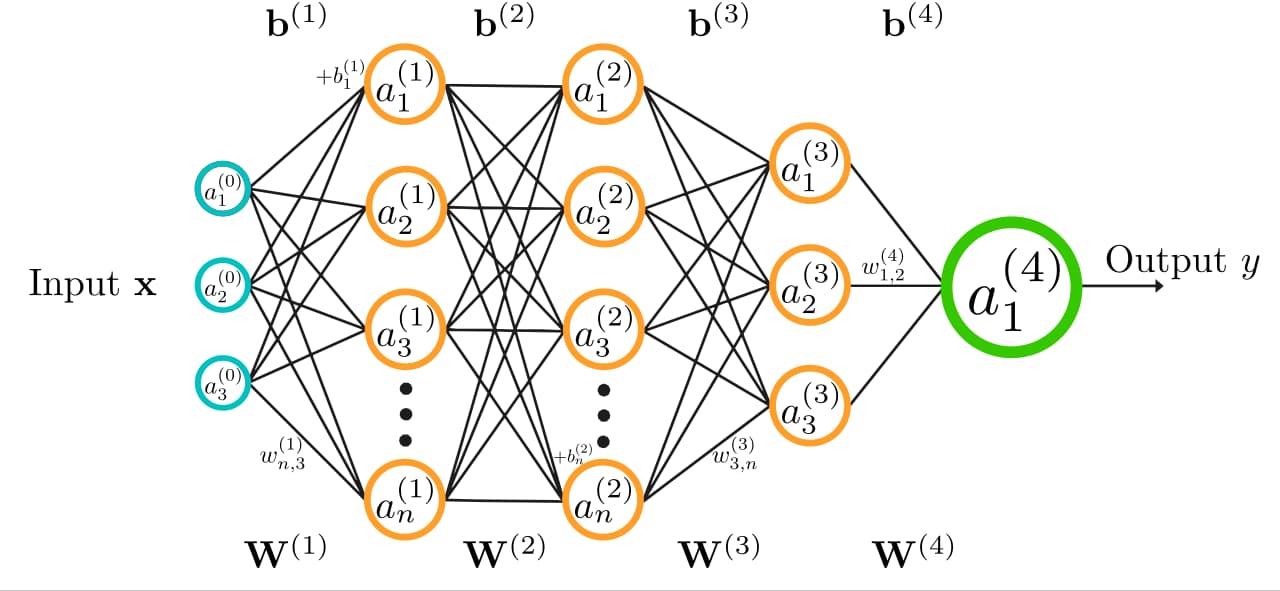
오늘날 AI 발전의 한가운데에는 딥러닝7이 있습니다. 딥러닝은 신경망을 여러 층으로 깊게 쌓아 배우는 머신러닝의 한 갈래입니다. 신경망은 노드(인공 뉴런)라는 계산 단위가 층층이 이어진 구조입니다. 앞 층의 계산 결과가 다음 층의 입력이 되고, 노드끼리의 연결마다 붙은 가중치8(신호를 얼마나 세게 전할지 정하는 숫자)를 학습으로 맞춥니다. 층이 3개를 넘는 신경망을 심층신경망, 곧 딥러닝이라고 부릅니다.
딥러닝의 강점은 사람이 골라 주던 특징을 스스로 뽑아낸다는 데 있습니다. 기존 머신러닝은 데이터의 어떤 면을 볼지 사람이 손으로 고르는 일이 많았지만, 딥러닝은 가공하지 않은 데이터를 바로 다루며 이 일을 대부분 자동으로 합니다. 그래서 글·사진·소리처럼 정해진 틀이 없는 데이터에 강하고, 챗봇·음성 인식·얼굴 인식 같은 일상 서비스의 바탕이 됐습니다.
신경망 자체는 머신러닝 초창기부터 있었지만, 대부분의 AI 분야에서 앞서 나간 것은 GPU(그래픽 처리 장치)가 발전한 2000년대 후반부터 2010년대 초반이었습니다. 딥러닝은 맞춰야 할 가중치가 수백만에서 수십억 개에 이르러, 기존 머신러닝보다 훨씬 많은 데이터와 계산이 필요하기 때문입니다. 많은 데이터를 저장하고 빠르게 분석해야 하니, 정보를 담고 처리하는 반도체의 성능도 함께 중요해졌습니다.
다만 한계도 분명합니다.
- 설명이 어렵습니다: 딥러닝은 확장성이 뛰어난 대신, 왜 그런 답을 냈는지 사람이 해석하기가 기존 머신러닝보다 어렵습니다.
- 데이터를 닮습니다: 학습 데이터에 검은 고양이 사진이 더 많으면, 검은 고양이는 잘 맞혀도 흰 고양이는 못 알아볼 수 있습니다. 데이터가 넓고 다양해야 정확도가 올라갑니다.
면접에서 이렇게 써먹기
면접에서 AI나 머신러닝을 설명해 보라는 질문을 받으면, 방식의 차이에서 학습법, 쓰임과 한계 순서로 답하면 정리가 쉽습니다.
- 방식의 차이: 규칙 기반 방식은 사람이 판단 기준을 짜 넣고, 머신러닝은 데이터에서 패턴을 배워 처음 보는 데이터를 예측합니다.
- 학습법: 정답이 있으면 지도학습, 정답 없이 묶음을 찾으면 비지도학습, 보상을 받으며 시행착오로 익히면 강화학습입니다.
- 딥러닝과 한계: 여러 층의 신경망이 특징을 스스로 뽑아 글·사진·소리에 강하지만, 많은 데이터와 계산이 들고 판단 이유를 설명하기 어렵습니다.
지원하는 직무에 맞춰 예를 하나 붙이면 더 좋습니다. 금융이라면 사기 거래와 실제 거래를 가르는 분류, 유통이라면 비슷한 고객을 묶는 시장 세분화나 상품 추천, 제조라면 공장 장비의 정비 일정 예측처럼 이어 볼 수 있습니다. 다만 AI가 무엇이든 해결한다는 식의 단정은 피하고, 데이터가 얼마나 넓고 고르냐에 결과가 달려 있다는 점을 덧붙이는 것이 좋습니다.
면접에서 왜 중요한가
머신러닝은 대규모 언어 모델과 생성형 AI까지 오늘날 대부분의 AI를 떠받치는 바탕이어서, 직무와 상관없이 AI를 설명해 보라는 질문의 출발점이 되기 때문입니다.
세 문제로 확인하기
복습 1 / 3
정답이 붙지 않은 고객 데이터에서 비슷한 고객끼리 묶어 시장을 나누려면 어떤 학습 방식이 알맞을까요?
복습 2 / 3
신경망이 2000년대 후반부터 2010년대 초반에 대부분의 AI 분야에서 앞서 나가게 된 배경으로 본문이 든 것은 무엇일까요?
복습 3 / 3
학습 데이터에 검은 고양이 사진이 훨씬 많을 때 생길 수 있는 문제는 무엇일까요?
출처 6개 보기
이 회차는 AI가 출처를 바탕으로 초안을 쓰고 운영자가 확인해 발행했습니다. 기사 문장을 옮기지 않고 사실만 새로 썼습니다.